
Pagine di phishing che spariscono: perché conservare subito le tracce
Una mail avvisa di un accesso al proprio account GitHub da Mosca. Il messaggio sembra credibile, il collegamento apre una pagina familiare e la richiesta di inserire il codice dell’autenticatore appare del tutto normale. Solo che l’indirizzo nella barra del browser non è quello di GitHub. È un dominio che gli somiglia, costruito per raccogliere password e codici di accesso.
Quando ci si accorge dell’inganno e si torna su quella pagina, può essere già troppo tardi per documentarla: il sito non risponde più, oppure rimanda a quello autentico. Il collegamento è ancora nell’email, ma ciò che si vede adesso è diverso da ciò che ha visto la vittima.
È uno degli aspetti più difficili da gestire nelle frodi online. Mentre si cerca di capire che cosa sia successo, le tracce cambiano. Conservare la pagina nelle prime ore può fare la differenza tra poter ricostruire il percorso dell’attacco e doverlo raccontare soltanto a memoria.
Una pagina credibile, con qualcuno nel mezzo
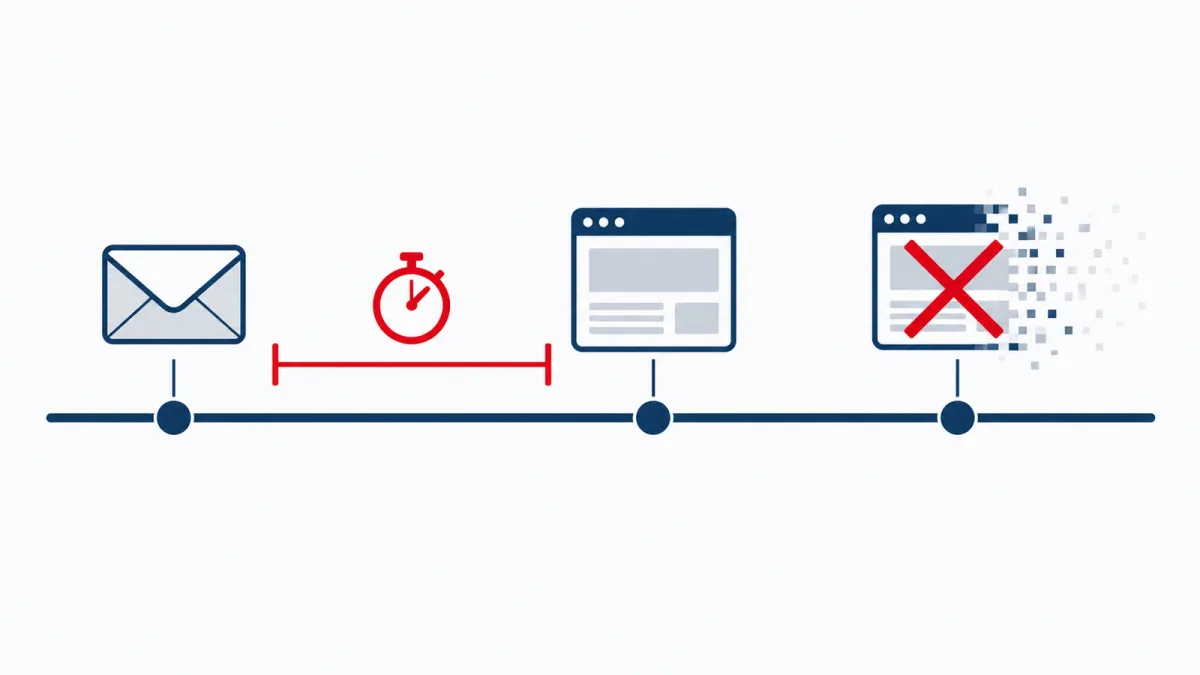
Il rapporto di OpenSourceMalware sul phishing associato a GhostAction descrive un caso di questo tipo. Secondo la cronologia riportata dai ricercatori, il 9 ottobre 2026 il dominio my-github[.]com ospitava una falsa pagina di accesso; il giorno successivo, il suo indirizzo principale reindirizzava già verso GitHub. È una finestra breve, anche se queste osservazioni, da sole, non consentono di stabilire per quanto tempo siano rimasti attivi tutti i percorsi usati nella campagna.
La pagina non si limitava a imitare il logo e i colori del servizio. Si interponeva tra il visitatore e GitHub, facendo da reverse proxy: recuperava contenuti del sito autentico e ne riscriveva gli indirizzi per far passare la navigazione attraverso l’infrastruttura degli aggressori. L’utente ritrovava così un ambiente riconoscibile, mentre chi controllava il dominio poteva intervenire nel flusso di accesso.
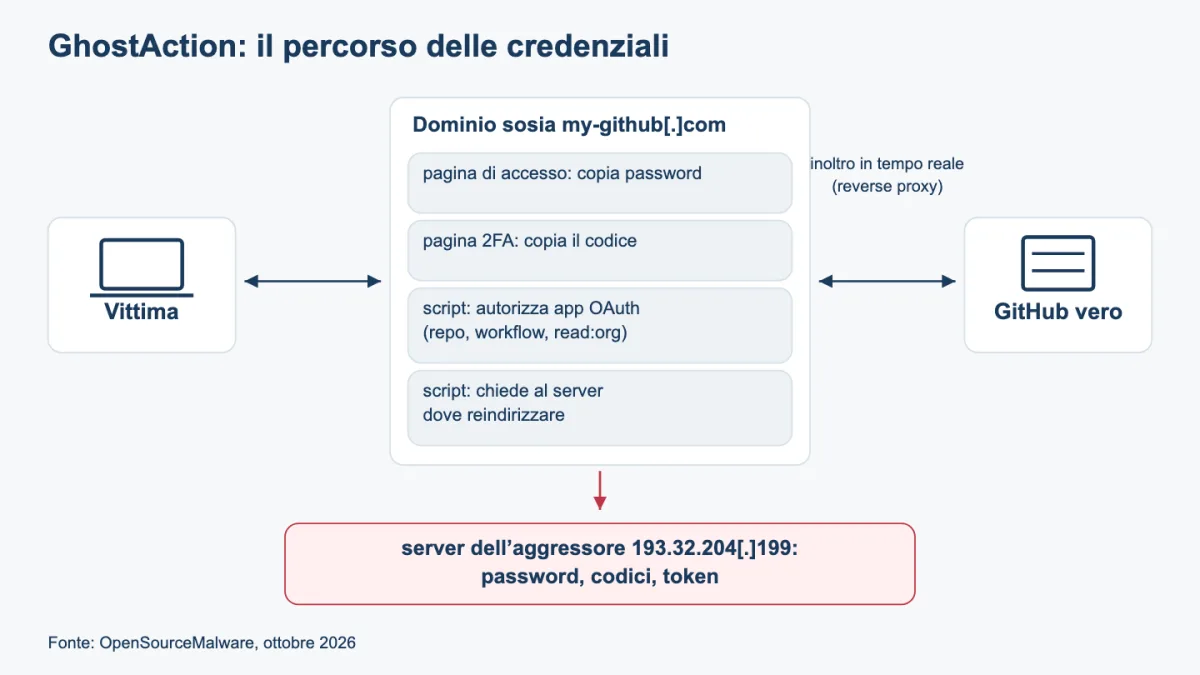
Nell’analisi vengono descritti la raccolta di nome utente e password, una falsa schermata per il codice dell’autenticatore e uno script predisposto per autorizzare un’applicazione OAuth con ampi permessi sui repository. Un altro script chiedeva periodicamente al server dove reindirizzare il visitatore: la destinazione finale poteva quindi cambiare durante la sessione.
OpenSourceMalware collega questa infrastruttura a GhostAction, la campagna nota per il furto di segreti attraverso i flussi automatici di GitHub Actions. Il collegamento va attribuito al rapporto, anche perché, come segnalato nelle fonti del testo di partenza, è stato messo in discussione da un altro ricercatore. Per il problema della conservazione delle prove, però, il punto più interessante è un altro: a permettere la ricostruzione del phishing è stato un archivio del traffico di rete della vittima, un file HAR.
Quel file conservava richieste, risposte e dettagli che la pagina ormai scomparsa non avrebbe più restituito. I ricercatori hanno potuto esaminare gli script, individuare gli indirizzi usati per raccogliere i dati e seguire la successione degli eventi. La sola email di esca avrebbe raccontato molto meno.
Quello che una schermata non riesce a conservare
Uno screenshot è utile. Mostra il messaggio apparso sullo schermo, la grafica scelta per renderlo credibile, talvolta anche l’indirizzo visitato. Se è tutto ciò che si ha a disposizione, va conservato. Ma quando occorre capire come funzionasse la pagina, l’immagine lascia aperte parecchie domande.
Dove venivano inviati i dati del modulo? Quali script erano stati caricati? Il browser aveva ricevuto un reindirizzamento? Quale server aveva risposto? E a quale momento risale il materiale raccolto?
Anche salvare la pagina dal browser o stamparla in PDF restituisce soltanto una parte del quadro. Una pagina dinamica dipende da risorse e richieste successive al caricamento iniziale; riaprendola fuori dal suo contesto, alcuni contenuti possono mancare. Il PDF ne conserva una rappresentazione visiva, ma non documenta da solo gli scambi di rete che l’hanno prodotta.
Un’acquisizione forense serve a raccogliere queste diverse tracce insieme e a rendere controllabile il modo in cui sono state conservate. Non recupera ciò che è già scomparso e non garantisce, da sola, una particolare conclusione giudiziaria. Offre però materiale sul quale svolgere verifiche successive, anche quando il sito originale non è più disponibile.
Come C.E.R.T.O. conserva la navigazione
Con il modulo Pagine web di C.E.R.T.O., l’operatore apre il sito in un browser integrato e avvia la registrazione. Da quel momento vengono raccolti il traffico osservato durante la sessione e la documentazione di ciò che compare sullo schermo. Alla fine, questi elementi confluiscono in un fascicolo di acquisizione.
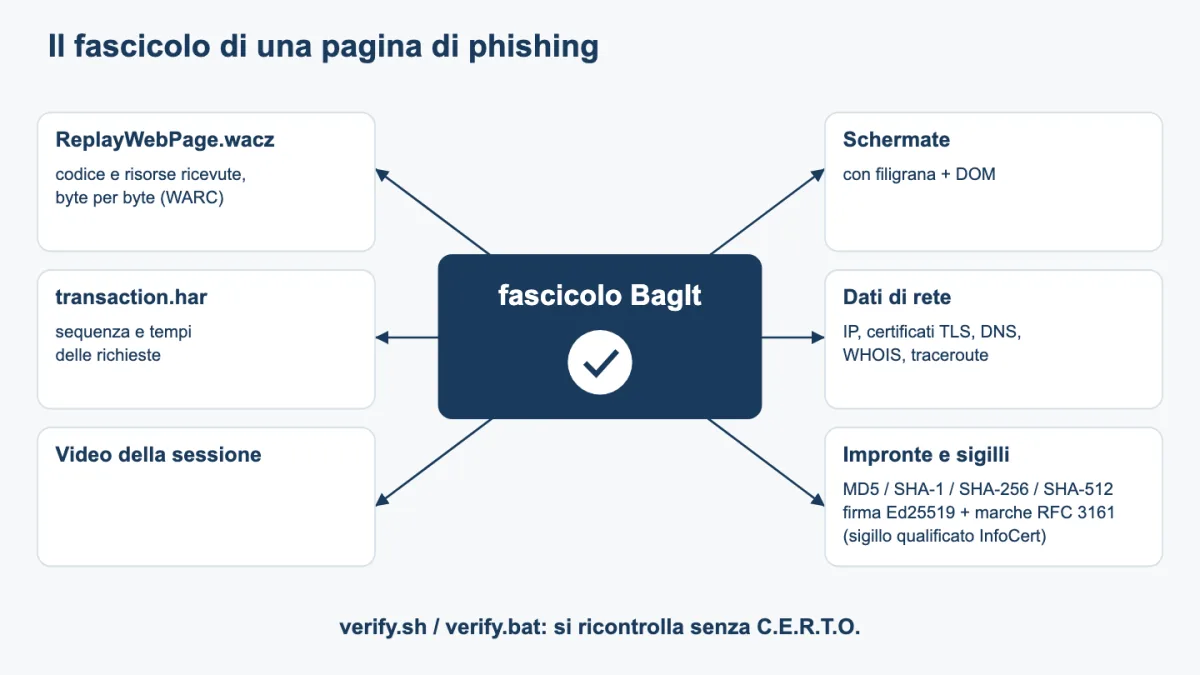
Una parte centrale del fascicolo è l’archivio WACZ. È un formato aperto che raccoglie i record della navigazione in un archivio WARC, insieme agli indici e alle informazioni necessarie per consultarli. Nel file ReplayWebPage.wacz trovano posto le risorse acquisite, le richieste e le risposte registrate, l’elenco delle pagine visitate e le impronte dei contenuti.
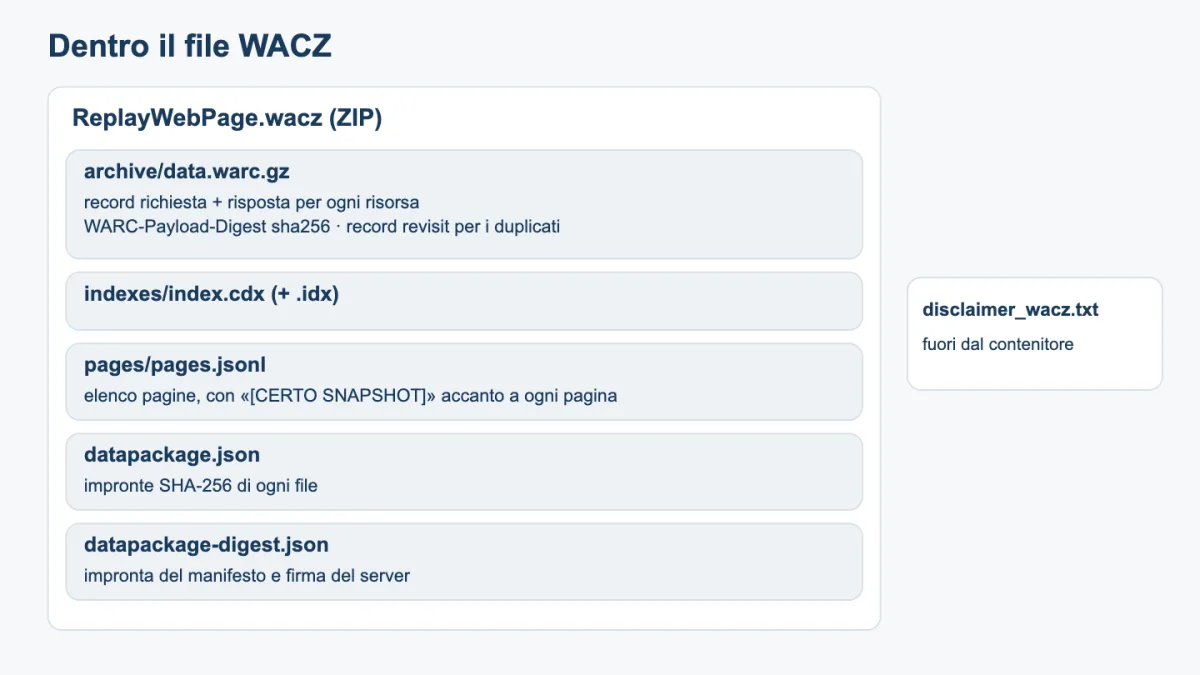
Per chi analizza un tentativo di phishing, questo significa poter tornare sul codice HTML e sugli script raccolti durante la visita. Se il browser ha acquisito uno script che invia credenziali a un determinato indirizzo, quel codice può essere esaminato anche dopo la rimozione del sito. Naturalmente, il contenuto del fascicolo dipende da ciò che è stato effettivamente osservato e registrato nella sessione: visitare la prima pagina non equivale a documentare automaticamente ogni passaggio dell’attacco.
La riproduzione di un sito archiviato presenta poi un problema pratico. Alcune pagine, quando vengono riaperte, tentano di contattare servizi che non sono più raggiungibili e finiscono per mostrare un errore. Per questo C.E.R.T.O. affianca alla cattura di rete uno snapshot del DOM, cioè della struttura della pagina così come risultava nel browser. Questa copia, contrassegnata come «[CERTO SNAPSHOT]», viene privata degli script e dotata di una regola di sicurezza che ne impedisce l’esecuzione. La trasformazione è dichiarata e la copia resta distinta dai contenuti acquisiti dalla rete.
Il fascicolo contiene anche un file di spiegazione bilingue, disclaimer_wacz.txt, che chiarisce questi limiti di riproduzione. Il WACZ può essere consultato con un lettore compatibile, come ReplayWeb.page, oppure con il lettore presente nelle Utilità Forensi di C.E.R.T.O.
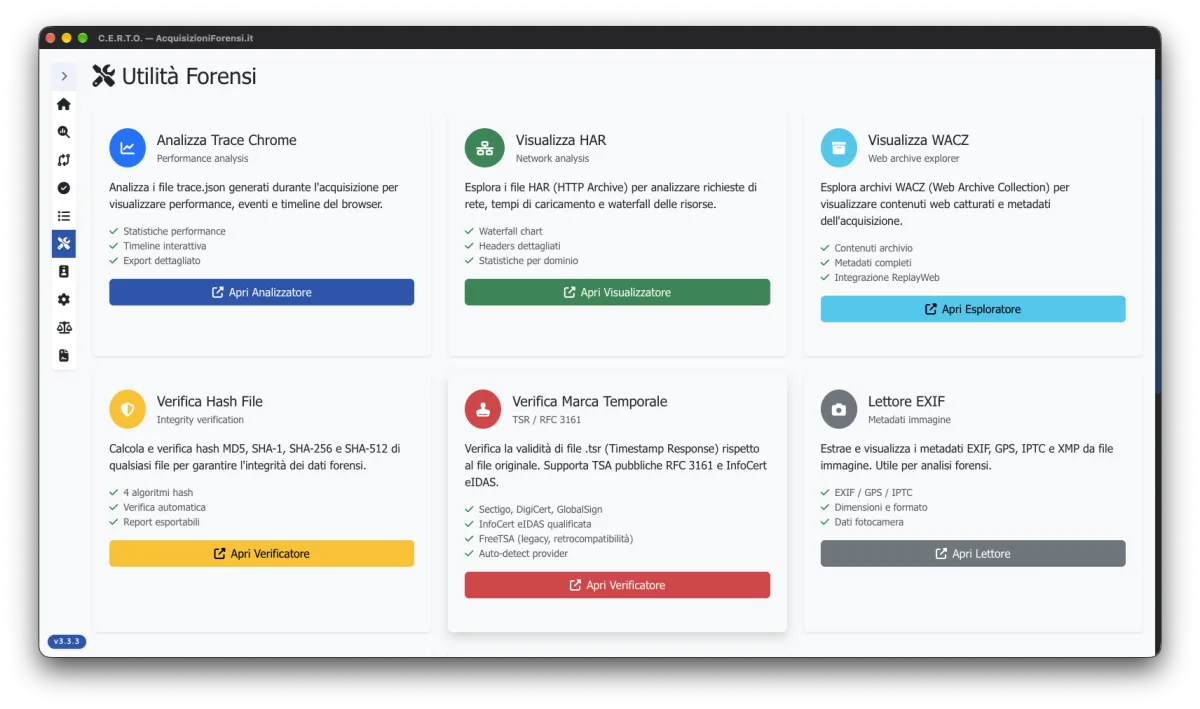
Accanto all’archivio web viene salvato network/transaction.har. È il registro che permette di seguire la sessione attraverso gli indirizzi contattati, le intestazioni, i tempi e i reindirizzamenti. WACZ e HAR si completano: chi esamina il caso può passare dal contenuto di una risposta al momento e al contesto in cui è stata ricevuta.
La registrazione video e le schermate aiutano invece a leggere la stessa sequenza dal punto di vista di chi navigava. Documentano ciò che l’operatore ha visto e fatto, comprese le eventuali richieste di accesso e i passaggi successivi. Le immagini riportano una filigrana con indirizzo, data, ora e identificativo dell’acquisizione; vengono conservati anche gli snapshot del DOM. È materiale utile per spiegare il caso a chi non deve necessariamente entrare nel dettaglio di uno script o di una richiesta HTTP.
Il server, le impronte e il riferimento temporale
La pagina visibile è soltanto una parte dell’acquisizione. Il fascicolo raccoglie anche informazioni sull’infrastruttura contattata: indirizzi IP, certificati TLS, interrogazioni DNS, dati WHOIS e percorso di rete. Un dominio registrato da poco o un indirizzo condiviso con altre risorse possono orientare gli approfondimenti, pur senza identificare automaticamente chi ha organizzato la frode.
Alla chiusura della sessione, i file vengono associati a impronte crittografiche. Queste consentono di controllare se il materiale è cambiato dopo la produzione del fascicolo. Il manifesto viene firmato con una chiave Ed25519 della postazione e il processo prevede marche temporali RFC 3161. Nella versione 3.3 descritta nel testo di partenza, il sigillo esterno del fascicolo riceve una marca temporale qualificata eIDAS rilasciata da InfoCert.
È utile distinguere il ruolo di ciascun elemento. L’impronta permette di verificare l’integrità di un file; la marca temporale lega i dati marcati a un riferimento temporale indipendente. Non certifica, da sola, che ogni affermazione apparsa sul sito fosse vera, né identifica l’autore della pagina. Anche il confronto dell’orologio della postazione con server NTP viene documentato, dichiarandone lo scarto nel rapporto.
Il risultato è organizzato secondo il formato BagIt e comprende rapporti, un cruscotto HTML consultabile offline e strumenti di verifica per Windows e per gli ambienti che possono eseguire lo script verify.sh. Il materiale può così essere consegnato a un consulente o a chi segue il caso, con la possibilità di ricontrollarlo senza dover disporre della stessa installazione di C.E.R.T.O. È prevista anche la verifica dell’acquisizione tramite il suo codice.
Se il sito è già cambiato
Tornare sul dominio e trovare il sito autentico non significa necessariamente che il collegamento ricevuto fosse innocuo. Potrebbe essere cambiata la risposta del server. Anche questa situazione può essere documentata, purché si sia chiari su ciò che si sta acquisendo: un reindirizzamento osservato oggi non dimostra, da solo, quale pagina fosse presente ieri.
L’email originale diventa allora particolarmente importante. Conservare il messaggio completo, con le intestazioni e i collegamenti, permette di affiancarlo alle tracce ancora disponibili. Gli eventuali archivi di rete già raccolti possono aggiungere ulteriori elementi alla ricostruzione.
Dopo l’acquisizione, il modulo OSINT consente di approfondire il dominio, l’indirizzo IP e il dominio del mittente. Le interrogazioni di registri pubblici, DNS, RDAP e registri di trasparenza dei certificati possono far emergere date, assegnazioni e relazioni fra risorse. Ogni dato va letto insieme alla sua fonte e al momento della consultazione. Sapere a quale fornitore è assegnato un server, per esempio, non equivale a sapere chi lo stesse usando per il phishing.
Conservare le tracce e segnalare l’abuso
Le segnalazioni al servizio imitato, al registrar, al fornitore di hosting e ai servizi di protezione dei browser possono contribuire a rendere la pagina irraggiungibile. È proprio questo il loro scopo. Se occorre documentare il contenuto, conviene quindi raccogliere tempestivamente ciò che è disponibile, senza trasformare l’acquisizione in un motivo per ritardare la messa in sicurezza degli account coinvolti.
Il fascicolo potrà poi accompagnare la ricostruzione dei fatti e l’eventuale denuncia, mettendo a disposizione di chi esamina il caso qualcosa di più del solo collegamento ricevuto per email.
Una pagina fraudolenta può essere sostituita nel giro di poche ore. Le richieste registrate, il codice conservato e le immagini della sessione permettono di continuare a studiarla anche dopo. Nel caso descritto da OpenSourceMalware, è stato proprio un archivio del traffico a lasciare aperta questa possibilità, quando il dominio aveva già cominciato a mostrare altro.